

Veri Madenciliği Nedir, Neden Önemli? Yöntemler ve Örnekler

 Creator
Evet, veri madenciliği bugün de önemli: büyük veri yığınlarındaki kalıpları ve ilişkileri ortaya çıkararak dolandırıcılık tespiti, talep tahmini, müşteri segmentasyonu ve öneri sistemleri gibi kararları besler. İstatistik, makine öğrenmesi ve veritabanı yöntemlerini birlikte kullanır; amaç verinin kendisini değil, veriden bilgiyi çıkarmaktır. Kişisel veriyle çalışıyorsan Türkiye’de KVKK’ya uyman gerekir.
Son güncelleme: 23.10.2026
1. Veri Madenciliği Nedir?
Veri madenciliği, “veritabanlarında bilgi keşfi” (KDD) sürecinin analiz adımıdır: büyük veri setlerindeki kalıpları istatistik, makine öğrenmesi ve veritabanı yöntemleriyle bulur. Adı biraz yanıltıcıdır; kazılan şey verinin kendisi değil, verideki bilgidir. Klasik veri analizinden farkı, önceden kurulmuş bir hipotezi test etmek yerine bilinmeyen kalıpları aramasıdır.
1.1. Veri Madenciliğinin Amaçları
Tanımlayıcı (betimsel) analiz: Verideki mevcut durumu, grupları ve dağılımları ortaya koymak.
Tahmine dayalı analiz: Geçmiş verilerden model kurarak gelecekteki bir değeri ya da sınıfı tahmin etmek.
İlişki keşfi: Birlikte görülen olayları ve kuralları bulmak (ör. birlikte alınan ürünler).
2. Veri Madenciliği Süreci
Sektörde en çok bilinen çerçeve, 1996’da tasarlanıp 1999’da yayımlanan CRISP-DM’dir. Altı aşamadan oluşur ve aşamalar arasında geri dönmek olağandır:
CRISP-DM aşaması | Ne yapılır? |
|---|---|
İşi anlama | Çözülecek iş sorusu ve başarı ölçütü belirlenir. |
Veriyi anlama | Veri kaynakları toplanır, ilk keşif ve kalite kontrolü yapılır. |
Veriyi hazırlama | Temizleme, birleştirme, dönüştürme; genellikle en çok zamanı alan aşama. |
Modelleme | Sınıflandırma, kümeleme, regresyon gibi yöntemler uygulanır. |
Değerlendirme | Sonucun iş sorusuna gerçekten cevap verip vermediği kontrol edilir. |
Devreye alma | Model ya da bulgular rapora, panoya veya ürüne taşınır. |
Aşağıdaki adımlar bu sürecin pratikteki karşılığıdır:
2.1. Veri Toplama
Veri toplama, veri madenciliğinin ilk adımıdır. Bu aşamada, veri kaynakları belirlenir ve veriler toplanır. Veri kaynakları şunları içerebilir:
- Veri tabanları
- Web siteleri
- Sosyal medya platformları
- Anketler ve diğer araştırma yöntemleri
2.2. Veri Ön İşleme
Toplanan veriler genellikle ham ve düzensizdir. Veri ön işleme, verilerin temizlenmesi, dönüştürülmesi ve analiz için uygun hale getirilmesi sürecidir. Bu aşama şunları içerir:
- Eksik verilerin tamamlanması
- Aykırı değerlerin tespiti ve düzeltilmesi
- Verilerin normalleştirilmesi
2.3. Veri Analizi
Veri analizi, veri madenciliğinin en kritik aşamasıdır. Bu aşamada, çeşitli teknikler ve algoritmalar kullanılarak veriler analiz edilir. Yaygın yöntemler arasında şunlar vardır:
- Sınıflandırma: Verileri belirli kategorilere ayırmaktır.
- Kümeleme: Benzer özelliklere sahip verileri gruplamaktır.
- Regresyon: Sayısal bir değeri (ör. satış miktarı ya da fiyat) tahmin etmek için değişkenler arasındaki ilişkiyi modellemektir.
2.4. Sonuçların Değerlendirilmesi
Analiz sonuçlarının değerlendirilmesi, elde edilen bilgilerin doğruluğunu ve geçerliliğini kontrol etmek için önemlidir. Bu aşamada, sonuçların anlamlılığı ve uygulanabilirliği incelenir.
2.5. Sonuçların Yorumlanması ve Raporlama
Sonuçların yorumlanması, veri madenciliğinin nihai amacıdır. Elde edilen bulgular, karar verme süreçlerinde kullanılmak üzere raporlanır. Bu aşamada, görsel grafikler ve tablolar kullanarak sonuçlar daha anlaşılır hale getirilir.
3. Veri Madenciliği Yöntemleri
Veri madenciliğinde kullanılan bazı yaygın yöntemler şunlardır:
3.1. Sınıflandırma
Sınıflandırma, verilerin belirli sınıflara ayrılmasını sağlar. Örneğin, bir e-posta mesajının spam olup olmadığını belirlemek için sınıflandırma algoritmaları kullanılabilir. Yaygın sınıflandırma algoritmaları arasında şunlar vardır:
Karar ağaçları : Karar ağaçları, verilerdeki belirli özelliklere dayalı olarak karar verme sürecini modelleyen ağaç yapısında bir grafiksel temsil sunar. Her dal, bir karar veya koşulu temsil ederken, her yaprak ise bir son durumu veya sonucu gösterir.
Destek vektör makineleri (SVM) : SVM, veri noktalarını en iyi ayıran hiper düzlemi bulmayı amaçlayan bir algoritmadır. Bu hiper düzlem, farklı sınıfları ayıran en geniş alanı (margin) sağlayacak şekilde yerleştirilir.
Naive Bayes : Naive Bayes, Bayes teoremi üzerine kurulu bir sınıflandırma yöntemidir. "Naive" (saf) ifadesi, algoritmanın her özelliğin (veya kelimenin) birbirinden bağımsız olduğunu varsaymasından gelmektedir.
3.2. Kümeleme
Kümeleme, benzer özelliklere sahip veri noktalarını gruplamak için kullanılmaktadır. Bu yöntem, veri setindeki doğal grupları keşfetmek için etkilidir. Yaygın kümeleme algoritmaları arasında şunlar vardır:
K-means : K-means, veri noktalarını k sayıda küme (cluster) oluşturacak şekilde gruplandıran bir algoritmadır. Her küme, o kümedeki veri noktalarının ortalaması (merkezi) ile temsil edilir.
Hiyerarşik kümeleme : Hiyerarşik kümeleme, veri noktalarını, benzerliklerine veya uzaklıklarına göre ağaç yapısında (dendrogram) organize eden bir algoritmadır. Bu yöntem, veri noktalarını alt gruplara (küme) ayırarak bir hiyerarşi oluşturur.
DBSCAN : DBSCAN, veri noktalarını yoğunluklarına göre gruplandırarak kümeler oluşturan bir denetimsiz öğrenme yöntemidir. Bu algoritma, yoğun bölgeleri belirleyerek bu bölgelerdeki veri noktalarını küme olarak gruplandırır ve daha az yoğun bölgeleri gürültü (noise) olarak değerlendirir.
3.3. Regresyon
Regresyon analizi, bağımlı ve bağımsız değişkenler arasındaki ilişkiyi modellemek için kullanılmaktadır. Örneğin, bir ürünün fiyatının talep ile nasıl değiştiğini anlamak için regresyon analizi yapılabilir. Yaygın regresyon türleri şunlardır:
- Doğrusal regresyon
- Lojistik regresyon (adında regresyon geçse de çoğunlukla evet/hayır gibi iki sonuçlu sınıflandırmada kullanılır)
- Polinom regresyon
3.4. Birliktelik Kuralları
Birliktelik kuralları, veriler arasındaki ilişkileri keşfetmek için kullanılır. Örneğin, bir müşteri alışveriş yaparken hangi ürünleri birlikte satın alma eğiliminde olduğunu belirlemek için kullanılabilir. Bu alandaki en bilinen algoritma, Agrawal ve Srikant’ın 1994’te önerdiği Apriori’dir.
4. Veri Madenciliği Uygulamaları
Veri madenciliği, birçok sektörde farklı uygulama alanlarına sahiptir:
4.1. Perakende Sektörü
Perakende sektöründe, veri madenciliği müşteri davranışlarını analiz etmek, satış tahminleri yapmak ve stok yönetimini optimize etmek için kullanılır. Örneğin, bir markette hangi ürünlerin birlikte satın alındığını belirlemek için birliktelik kuralları kullanılabilir.
4.2. Finans Sektörü
Finans sektöründe, veri madenciliği dolandırıcılık tespiti, kredi risk değerlendirmesi ve yatırım stratejileri geliştirmek için kullanılır. Örneğin, kredi başvurularının değerlendirilmesinde sınıflandırma algoritmaları kullanılabilir.
4.3. Sağlık Sektörü
Sağlık sektöründe, veri madenciliği hasta verilerini analiz ederek hastalıkların erken teşhisi, tedavi süreçlerinin iyileştirilmesi ve sağlık hizmetlerinin optimizasyonu için kullanılır. Örneğin, hastaların sağlık geçmişi üzerinden risk analizi yapılabilir.
4.4. Sosyal Medya
Sosyal medya platformları, kullanıcı davranışlarını analiz etmek, içerik önerileri yapmak ve reklam hedeflemesi için veri madenciliğinden yararlanır. Örneğin, kullanıcıların ilgi alanlarına göre içerik önerileri sunmak için kümeleme yöntemleri kullanılabilir.
İlgini çekebilir: 2024 Nobel Fizik Ödülü Yapay Sinir Ağları Keşiflerine Verildi
5. Veri Madenciliğinde Etik ve Gizlilik
Veri madenciliği çoğu zaman kişilerin davranışlarıyla ilgili veriler üzerinde çalışır; bu da gizlilik riskini beraberinde getirir. Türkiye’de kişisel verileri işlerken 6698 sayılı Kişisel Verilerin Korunması Kanunu’na (KVKK) uyman gerekir: veriyi açık rızaya ya da Kanun’un 5. maddesindeki diğer hukuki sebeplerden birine dayandırmalı, ilgili kişileri aydınlatmalı (10. madde) ve yalnız amaca yetecek kadar veri işlemelisin.
5.1. Veri Gizliliği
Sağlık verisi gibi özel nitelikli kişisel veriler (KVKK 6. madde) daha sıkı kurallara tabidir. Mümkün olduğunda veriyi anonimleştir ya da takma adlandır (pseudonymization), erişimi sınırla ve veriyi hangi amaçla topladığını açıkça anlat. Model eğitimi bittiyse gereksiz kişisel veriyi saklama.
5.2. Etik Kullanım
Etik kullanım, elde edilen bilginin kişilere zarar verecek biçimde kullanılmaması demektir. Örneğin geçmiş veride var olan önyargılar modele taşınırsa kredi ya da işe alım kararlarında bazı gruplar haksız yere dezavantajlı hale gelebilir. Bu yüzden modelin sonuçlarını farklı gruplar için ayrıca kontrol etmek iyi bir alışkanlıktır.
Sonuç
Veri madenciliği, veriyi karara dönüştürmenin temel yollarından biri olmaya devam ediyor. Doğru soruyla başlayıp CRISP-DM gibi bir süreç izlersen büyük veri setlerinden işe yarar sonuçlar çıkarabilirsin. Kişisel veriyle çalışırken KVKK’ya uymak ve sonuçları önyargıya karşı kontrol etmek işin ayrılmaz parçası.
Sık Sorulan Sorular
Veri madenciliği ile veri analizi arasındaki fark nedir?
Veri analizi genellikle önceden kurulmuş bir hipotezi test eder ya da bilinen bir soruyu cevaplar. Veri madenciliği ise büyük veri içinde önceden bilinmeyen kalıpları ve ilişkileri ortaya çıkarmaya odaklanır.
Veri madenciliği ile makine öğrenmesi aynı şey mi?
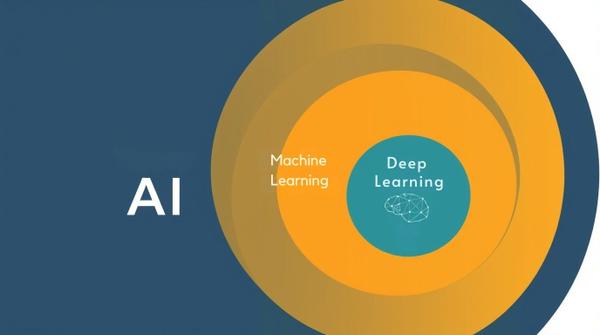
Hayır ama iç içe. Makine öğrenmesi veriden öğrenen algoritmaları geliştirir; veri madenciliği bu algoritmaları (karar ağaçları, kümeleme, sinir ağları gibi) istatistik ve veritabanı teknikleriyle birlikte kullanarak veriden bilgi çıkarır.
Veri madenciliğinde hangi araçlar kullanılır?
Kod yazıyorsan Python (pandas, scikit-learn) ve R en yaygın seçenekler. Kod yazmadan başlamak istiyorsan KNIME, Orange ve Weka gibi açık kaynak araçlara bakabilirsin. Veriyi çekmek için SQL bilmek neredeyse her projede gerekir.
Veri madenciliği yasal mı?
Yöntemin kendisi yasal; önemli olan hangi veriyle çalıştığın. Kişisel veri kullanıyorsan Türkiye’de 6698 sayılı KVKK’ya uyman, veriyi bir hukuki sebebe dayandırman ve ilgili kişileri aydınlatman gerekir. Başka sitelerden veri toplarken o sitenin kullanım koşullarını da kontrol et.
Veri madenciliği öğrenmek için ne bilmek gerekir?
Temel istatistik, SQL ve bir programlama dili (çoğunlukla Python) iyi bir başlangıç. Ardından sınıflandırma, kümeleme ve regresyon yöntemlerini gerçek bir veri setiyle denemek, teoriden daha hızlı öğretir.
Kaynak: CRISP-DM süreç modeli, 6698 sayılı KVKK
Creator2025'te Robotik Devrimi: Endüstriyel Üretimde 10 Büyük Değişim
10 Yeni Yapay Zeka Trendi: Sanatta AI’nın Yükselişi